二分图最大权匹配KM算法介绍
一、定义
完备匹配 : X点集所有的点都参与了匹配。
可行边 : $lx[i]+ly[j] \geq w[i][j]$的边
相等子图 :包含所有点和可行边的子图。
顶标 : $lx[i],ly[j]$,人为赋值的点权,为了控制可行边而设立。
松弛量 :$\forall i \in Y,slack[y]=min(lx[x]+ly[i]-w[x][i])$
顶标修改量 : $d=min(slack[y])$
需要注意的是,松弛量和顶标修改量都是针对当前没有被匹配的Y部的点来操作的。
二、流程
基本思路
给X、Y两部点的顶标进行贪心地赋值,然后修改顶标值使得更多的边成为可行边,扩大相等子图,从而增加匹配,直到相等子图达到完备匹配。
算法步骤
①初始化设定$lx[i]=max_{i \to j}(w[i][j])$,$ly[i]=0$
②对每个X部的点,尝试增加匹配。更新Y部点的松弛量,并求得顶标修改量。记录下最终贡献顶标修改量的Y部节点,即为本次增广的匹配点。为了降低复杂度,需要记录改善匹配的路径(用前向星)。所以调整完所有的松弛量和顶标修改后,更新匹配状态。
③答案就是Y部每个点与对应X部匹配点之间连边权值之和
时间复杂度
$O(n^3)$
代码
注:这份代码适用于处理X、Y部节点数相等的情况
1 |
|
形象理解
参考网上对于这一算法的形象理解
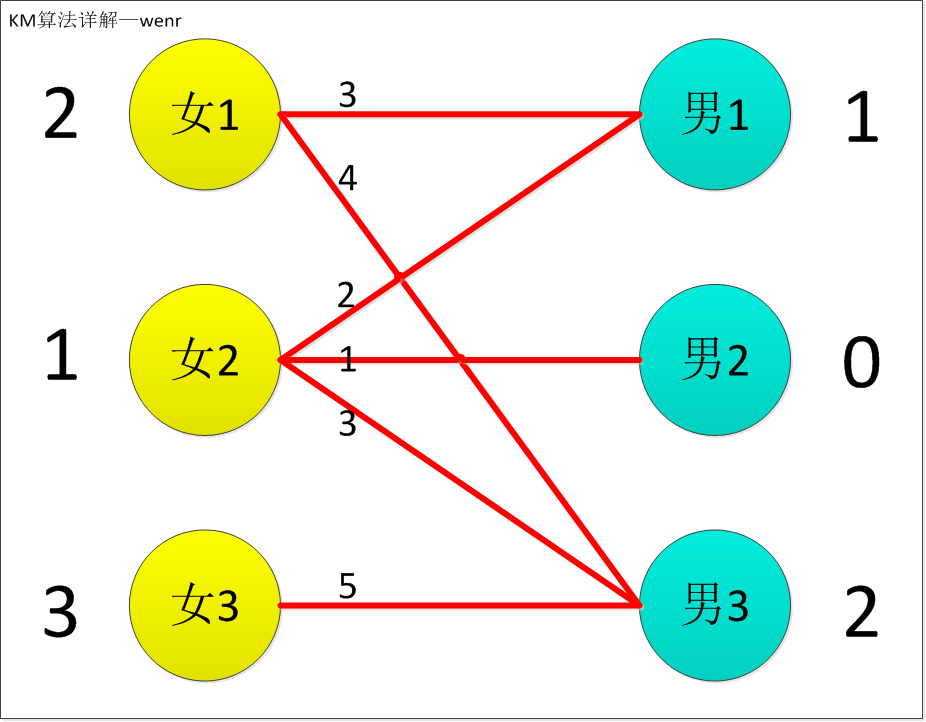
现在有N男N女,有些男生和女生之间互相有好感,我们将其好感程度定义为好感度,我们希望把他们两两配对,并且最后希望好感度和最大。
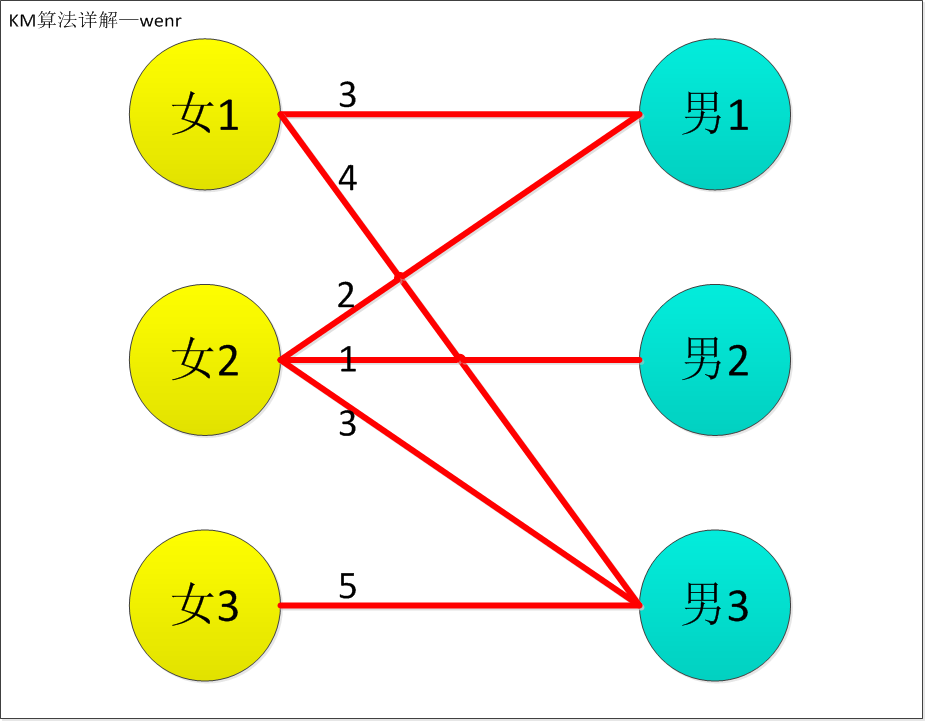
怎么选择最优的配对方法呢?
首先,每个女生会有一个期望值,就是与她有好感度的男生中最大的好感度。男生呢,期望值为0,就是……只要有一个妹子就可以啦,不挑~~
这样,我们把每个人的期望值标出来。
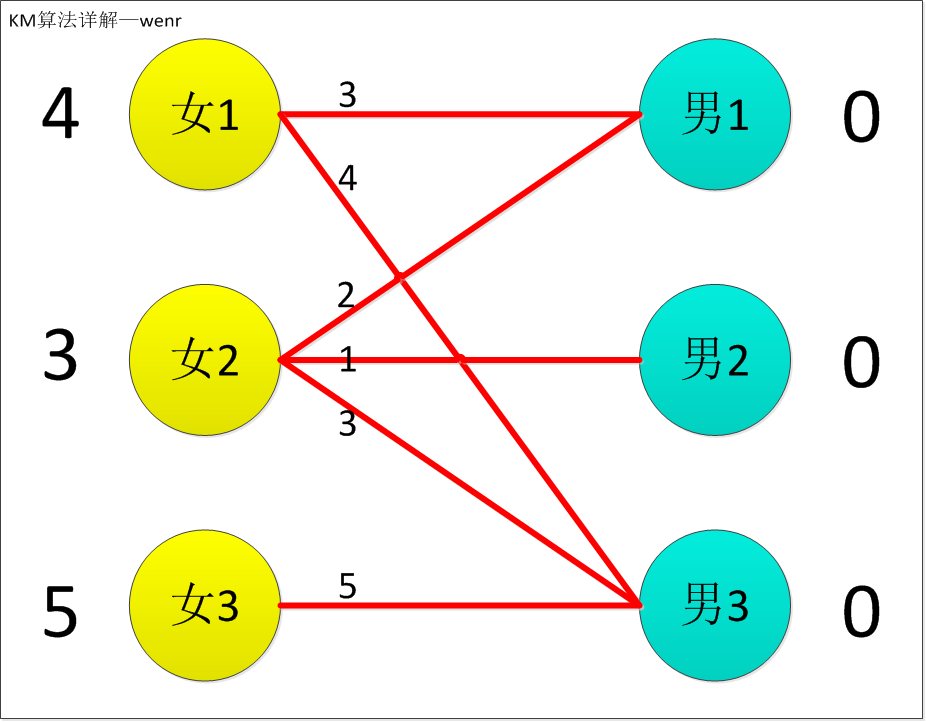
接下来,开始配对。
配对方法:
我们从第一个女生开始,分别为每一个女生找对象。
每次都从第一个男生开始,选择一个男生,使男女两人的期望和要等于两人之间的好感度。
注意:每一轮匹配,每个男生只会被尝试匹配一次!
具体匹配过程
为女1找对象
(此时无人配对成功)
根据 “男女两人的期望和要等于两人之间的好感度”的规则
女1-男1:4+0 $\not=$ 3
女1-男3:4+0 $=$ 4
所以女1选择了男3
女1找对象成功
为女2找对象
(此时女1—男3)
根据配对原则,女2选择男3
男3有主女1,女1尝试换人
我们尝试让女1去找别人
尝试失败
为女2找对象失败!
为女2找对象失败
这一轮参与匹配的人有:女1,女2,男3。
怎么办???很容易想到的,这两个女生只能降低一下期望值了,降低多少呢?
任意一个参与匹配女生能换到任意一个 这轮 没有被选择过的男生所需要降低的最小值
比如:女1选择男1,期望值要降低1。 女2选择男1,期望值要降低1。 女2选择男2,期望值要降低2。
于是,只要期望值降低1,就有妹子可能选择其他人。所以妹子们的期望值要降低1点。
同时,刚才被抢的男生此时非常得意,因为有妹子来抢他,于是他的期望值提高了1点(就是同妹子们降低的期望值相同)。
于是期望值变成这样(当然,不参与刚才匹配过程的人期望值不变)
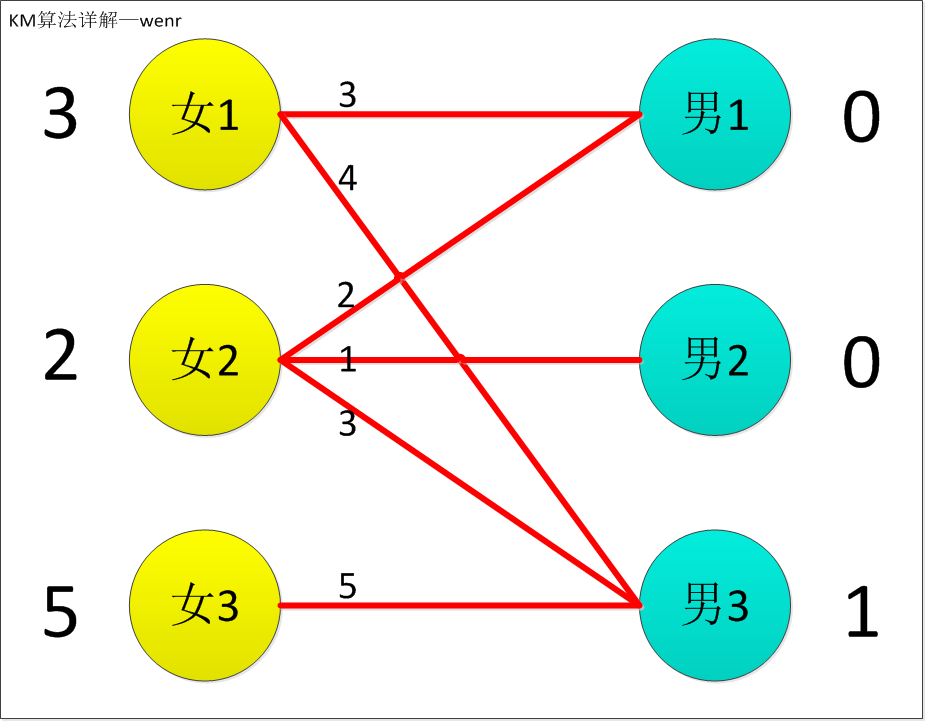
继续为女2找对象
(此时女1—男3)
女2选择了男1
男1还没有被配对
女2找对象成功!
为女2找对象成功
为女3找对象
(此时女1—男3,女2-男1)
女3没有可以配对的男生……
女3找对象失败
为女3找对象失败
此轮只有女3参与匹配
此时应该为女3降低期望值
降低期望值1的时候,女3-男3可以配对,所以女3降低期望值1
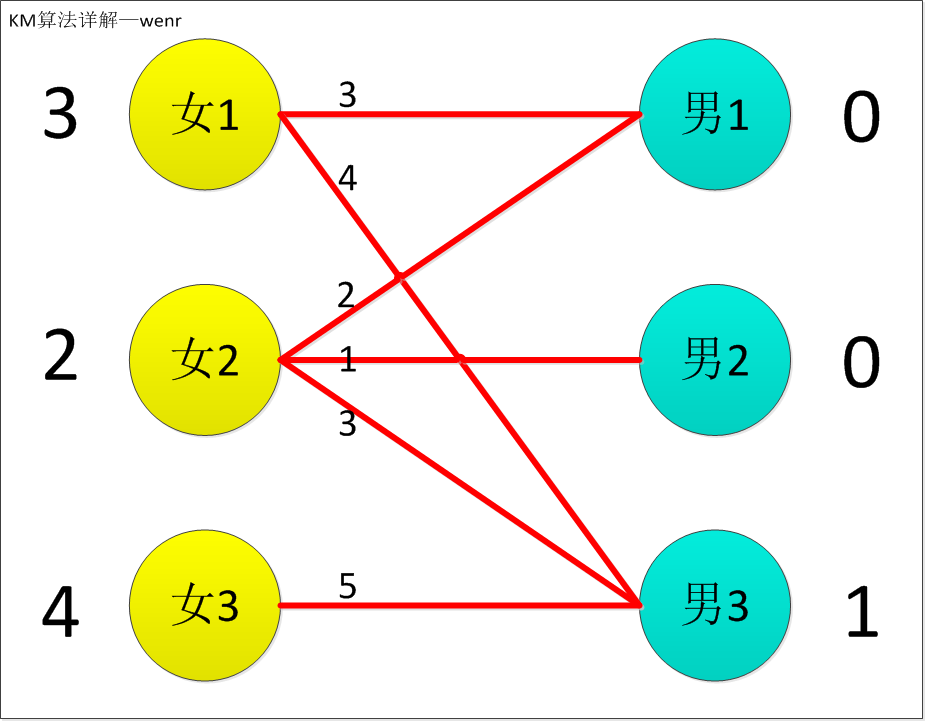
继续为女3找对象
(此时女1—男3, 女2-男1)
女3相中了男3
此时男3已经有主女1,于是女1尝试换人
女1选择男1
而男1也已经有主女2,女2尝试换人
前面说过,每一轮匹配每个男生只被匹配一次
所以女2换人失败
女3找对象再次失败
为女3找对象失败
这一轮匹配相关人员:女1,女2,女3,男1,男3
此时,只要女2降低1点期望值,就能换到男2
(前面提过 只要任意一个女生能换到任意一个没有被选择过的男生所需要降低的最小值)
我们把相应人员期望值改变一下
还是为女3找对象
(此时女1—男3, 女2-男1)
女3选择了男3
男3有主女1,女1尝试换人
女1换到了男1
男1已经有主女2,女2尝试换人
女2换人男2
男2无主,匹配成功!!!
为女3找对象成功
匹配成功!!!撒花~~
到此匹配全部结束
此时
女1-男1,女2-男2,女3-男3
好感度和为最大:9